原文:https://dev.to/renanfranca/when-skill-evolution-means-removing-instructions-3484(作者 @renanfranca)
两篇论文,一个熟悉的问题
最近我总有一种奇怪的体验:我先用很小、很务实的方式折腾某个东西,随后就冒出一篇论文,在比我的实验大得多的规模上探索一个惊人相似的问题。
最近就有两篇论文让我再次经历了这种情况。
第一篇是 “Evaluating Skills, Not Just Agents”,它提出了 ACES 和 Skill Lift:分别在有技能和没有技能的情况下执行同一个任务,然后度量两者的差异。
这和我之前在 skill-eval 里探索的方向直接对上了。
但那次实验给我最大的收获,其实是关于 A/B 测试的局限。
一次 A/B 对比只能为那个特定的模型、任务、上下文和执行框架(harness)提供证据,并不能证明一个技能放之四海而皆准。换一个模型,这个技能可能就没那么有用了,可能变得多余,甚至有害。
知识不一定非要变成指令
后来我读了 Google Research 的 “WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution”。
又一块拼图就此归位。
WikiSkill 把原始经验、积累下来的知识和真正可执行的技能区分开来。经验可以在技能之外持续积累,而针对技能提出的变更会先经过验证,通过后才被提升为正式内容。
更有意思的是,论文展示了一些案例:针对某个较弱的模型学到的底层绕行方案(workaround),迁移到更强的模型上效果很差。那些曾经帮到弱模型的指令,可能会束缚强模型,或者引发冗余的工具调用。
这与我在 skill-eval 里做的另一个实验非常接近。
靠做减法来演化技能
我尝试“演化”我的 implement-execplan 技能,方式不是增加更多指令,而是删除指令。
最初的基线版本有 228 行,自适应版本是 165 行。
新版本不再要求一个大而固定的计划结构和持续更新,而是更依赖模型自身的能力:必填小节更少,条件性信息只在有用时才提供,计划更新更少,例行的记录工作也更少。
技能在这里:
案例研究在这里:
skill-eval: implement-execplan case study
在第一次有效对比中,两个版本都通过了同样的质量门禁,而更小的版本少用了大约 18% 的候选输入 + 输出 token。
这只是一次观察结果,并不是新版本普遍更优的证明。复现工作并不完整,我也刻意把这一局限性记录了下来。
但它确实改变了我对“技能演化”的思考方式。
演化不一定意味着积累更多规则。
有时候是模型进步了,执行框架的一部分随之过时。
有时候,过去需要一条指令来约束的事情,可以变成一个确定性的测试、钩子(hook)或静态检查,然后从技能里彻底消失。
这也是我在逐步把 TDD 交给一个 Agent 时注意到的事情的延续。在 When I Entrusted TDD to an AI Agent 一文中,一些架构层面的指导在不再只是一条指令、而是变成仓库中可执行反馈之后,可靠性大幅提升。
还有些时候,一次失败值得记住,但还不值得变成一条指令。正是在这一点上,WikiSkill 对经验、持久知识与可执行技能的划分,让我觉得非常有道理。
我更倾向于先摸索出工作流
这也改变了我创建 skill 的方式。
我更愿意先亲历问题,手动和模型协作,反复调整工作流直到它能稳定跑通,然后再把学到的东西沉淀成一个 skill。
我最新的 implement-approved-plan skill 正是来自这样一个过程:
implement-approved-plan/SKILL.md
这个 skill 挺有意思,因为由 skill 本身在 ChatGPT Desktop 里协调一个多会话工作流。
一个专职的 Coordinator(协调者)持有已批准的计划,并控制一组专门化的会话。每个角色只创建一次,然后在整个实现过程中复用:Implementer(实现者)负责 TDD,Committer(提交者)掌管提交,Validator(验证者)跑完整的质量门禁,Habit Curator 处理由机械化检测得出的设计发现,还有一个独立的 Structural Reviewer(结构审查者)在实现已经全绿之后再去寻找设计问题。
专门化不只是给每个会话分配不同的职责,skill 还会给不同角色分配不同的模型。Coordinator、Implementer、Habit Curator 和 Structural Reviewer 运行在 xhigh 档位的 gpt-5.6-sol 上;Committer 运行在 xhigh 档位的 gpt-5.6-terra 上;Validator 则运行在 xhigh 档位的 gpt-5.6-luna 上。
这种路由让工作流更经济。Sol 留给开放式的实现、编排和设计判断;Terra 负责提交相关的工作,范围更窄但仍然需要对仓库规范做出判断;Luna 跑的基本上是确定性的验证门禁。关键不只是造出一批专家,而是在更经济的模型就够用的地方,避免动用旗舰模型。
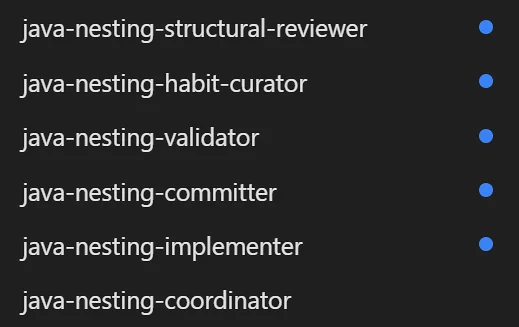
<figcaption>这些是 <code>implement-approved-plan</code> skill 为实现出色的 habit-hooks 项目中的 <a href="https://github.com/habit-hooks/habit-hooks/issues/160">habit-hooks issue #160</a> 而创建的会话。</figcaption>
从概念上看,它大致长这样:
Approved Plan
     ↓
Coordinator
     ↓
Implementer
     ↓
Coordinator
     ↓
Committer
     ↓
Coordinator
     ↓
Validator
     ↓
Coordinator
     ↓
Habit Curator
     ↓
Coordinator
     ↓
Structural Reviewer
     ↓
Final Validation
     ↓
PR + CI
     ↓
Ready for Merge
我觉得最有意思的一点是:这些会话之间并不自由互通。只有 Coordinator 会和各个专家会话对话,而对同一个工作树的访问则通过一个持久化的工作流账本(ledger)串行化。
这个账本的行为几乎就是一个小型状态机。它记录当前阶段、专家会话的 ID、提交、验证门禁、Habit 状态、pull request 和 CI 证据。它会拒绝非法的状态转换、对 checkout 的并发占用、过早发出的 pull request,以及在 GitHub 真正确认 PR 已合并之前就执行的清理。
它的形态比我在《我早已建过三个 Agentic 循环却从未给它们命名》(I Had Already Built Three Agentic Loops Without Naming Them)中描述的三层嵌套循环要精巧得多,但底层思路是相通的:当反馈和退出条件都固化在工作流里、而不是依赖模型自己记住一切时,自主性反而变得更安全。
所以这个 skill 并不是想让一个巨型 agent 变得更聪明。它只是把我此前一直手动执行的工作流编码下来,同时把尽可能多的协调与验证工作转移到模型外围的确定性机制里。
引入它的 PR:
而且我没有在 SKILL.md 看起来不错时就停下,而是用一个公开的测试夹具和一条真实的 pull request 实际跑了一遍这个工作流:
implement-approved-plan-fixture
implement-approved-plan-fixture#2
我当前的心智模型
于是我当前的心智模型慢慢变成了这样:
先亲历问题。
手动把工作流跑通。
把确定性的知识变成确定性的机制。
把还不确定的经验挡在 skill 之外,直到它证明自己值得留下。
只为模型仍然做不到的部分添加指令。
等模型变了,再重新审视这些指令。
没有什么魔法 skill,也不存在「指令越多 agent 就越好」的假设。
只有一条随着模型迭代、随着我对问题理解加深而不断调整的工作流。
原文:https://dev.to/renanfranca/when-skill-evolution-means-removing-instructions-3484(作者 @renanfranca)