原文:https://dev.to/g_factor/high-throughput-llm-inference-training-a-deep-dive-into-vllm-5818(作者 @gfactor)
编者按:本文最初发表于 g factor 工程博客。文中所有基准测试与遥测数据均在 gft-studio 的专用 NVIDIA H100 与 H200 集群上完成。
如果你有过这样的经历:生产环境跑着推理,你盯着 nvidia-smi,看到 GPU 计算利用率只有 12%,而用户还在抱怨生成太慢,心一下沉到谷底——那你就已经正面撞上了现代大语言模型(LLM)的一个核心现实:文本生成是一个伪装成计算问题的内存带宽问题。
当 Transformer 以 token 为单位逐个生成文本时,你那块价值几千美元的 GPU 几乎没在动用它的张量核心(tensor core)。恰恰相反,它几乎所有时间都在扮演仓库里的高速叉车——为每一个输出的词,把几十 GB 的模型权重和历史上的 Key-Value(KV)缓存张量在高带宽内存(HBM)里来回倒腾。
而当你从单用户的玩具 demo 跨进多租户生产服务,或者高吞吐的强化学习(RL)rollout,朴素的 PyTorch 技术栈立刻撞墙:内存碎片蚕食你的显存,静态批处理让 GPU 在巨大的“气泡”里空转,主机侧的驱动开销又让芯片饿着肚子。这正是 vLLM 能拿下推理世界的原因——不靠什么神秘黑魔法,而是靠一套优雅、久经实战考验的操作系统级工程:PagedAttention 与迭代级连续批处理(continuous iteration-level batching)。
核心概念速览
Token:*模型输入或输出的基本单位,通常相当于 3–4 个英文字符。
Prefill 阶段:*对整个 prompt 并行处理——计算密集型的稠密矩阵乘法(GEMM)。
Decode 阶段:*逐个串行生成后续 token——受内存带宽约束的矩阵-向量运算(GEMV)。
KV Cache:*存在显存里的历史 Key 和 Value 表示张量,避免注意力机制重算历史 token。
连续批处理(Continuous batching):*迭代级调度,任何一条序列生成完毕,等待中的请求立即加入批次。
1. KV Cache 瓶颈:显存为何反噬
自回归 Transformer 并不会一次性生成一整段话。prompt 到达时,模型会在 prefill(预填充)阶段并行处理全部输入 token。这是稠密、计算密集的矩阵乘法(GEMM)——GPU 生来就是干这个的。
但生成一开始(decode 阶段),情况就全变了。要生成第 501 个 token,模型需要对前面 500 个 token 做自注意力。如果每一步都从零重算这 500 个 token 的表示,就会陷入 {% katex inline %} O(N^2) {% endkatex %} 的计算噩梦。所以,我们把中间的 Key、Value 向量表示缓存进 GPU 显存:
{% katex %}
M_{\text{KV}} = 2 \times L \times H_{\text{KV}} \times d_{\text{head}} \times T \times b
{% endkatex %}
开头的因子 2 对应 Key 和 Value 各一份。{% katex inline %} L {% endkatex %} 是全注意力层的层数,{% katex inline %} H_{\text{KV}} {% endkatex %} 是每层的 KV 头数量,{% katex inline %} d_{\text{head}} {% endkatex %} 是头维度,{% katex inline %} T {% endkatex %} 是当前序列的 token 长度,{% katex inline %} b {% endkatex %} 是精度对应的字节数(例如 BF16 为 2 字节)。
关键的一点是,现代开放权重架构(如 Qwen3.6-27B)通过分组查询注意力(Grouped-Query Attention,GQA)来控制显存开销:16 个全注意力层、每层 4 个 KV 头、头维度 256。按 BF16 精度、8192 token 的序列长度算,仅一条序列就要占掉:
{% katex %}
M_{\text{KV}} = 2 \times 16 \times 4 \times 256 \times 8{,}192 \times 2\text{ bytes} = 536{,}870{,}912\text{ bytes} \approx 0.54\text{ GiB}
{% endkatex %}
半个 GB 听起来不算什么——直到你看到高负载下的真实情况。在标准 PyTorch 或基础的 Hugging Face generate() 流水线里,内存管理相当原始。DynamicCache 这类动态容器按需临时分配缓冲区。而在一个多用户服务里,可能一个用户只要 20 行的 bash 脚本,另一个却提交了 6000 token 的法律文书,分配、释放反反复复,你的 GPU 显存很快就被打成一块布满孔洞的瑞士奶酪。
这就是外部内存碎片(external memory fragmentation):你明明看到还有 15 GB 空闲显存,但它已经碎成了不连续的小块,下一个需要连续 2 GB 内存的请求一进来,直接撞上灾难性的 CUDA Out of Memory(OOM)。
2. PagedAttention:向 50 年前的操作系统杰作取经
早在 20 世纪 60 年代,操作系统的先驱们就意识到,要求程序必须驻留在一段连续的物理内存里简直是荒谬的。他们的解决方案是虚拟内存分页(virtual memory paging):把内存切成固定大小的页(通常为 4 KB),再由硬件通过页表把任意虚拟地址映射到零散分布的物理页上。
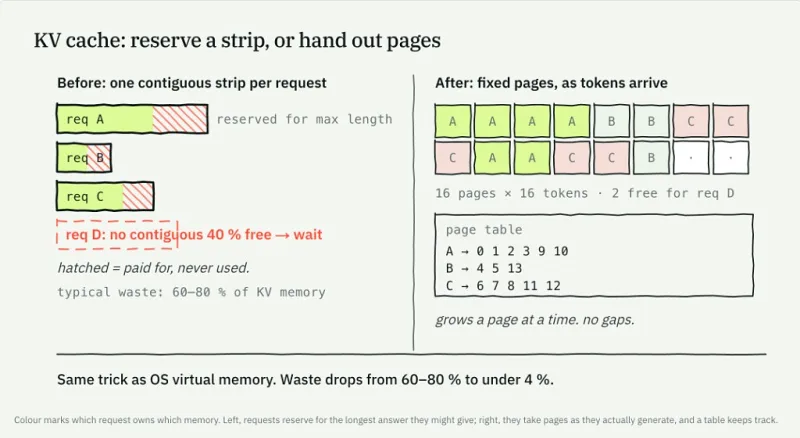
vLLM 把这套思路原封不动地搬到了显存管理上,这就是 PagedAttention:不再为每个序列按最坏情况长度预留一大块连续显存,而是把 KV Cache 切成固定大小的物理块(每块通常装 16 或 32 个 token)。
图解 KV Cache 的预留方式
下面以最大长度 12 个 token、同时服务 3 个并发请求(分别已持有 3、5、2 个 token)为例,对比不同的显存分配策略:
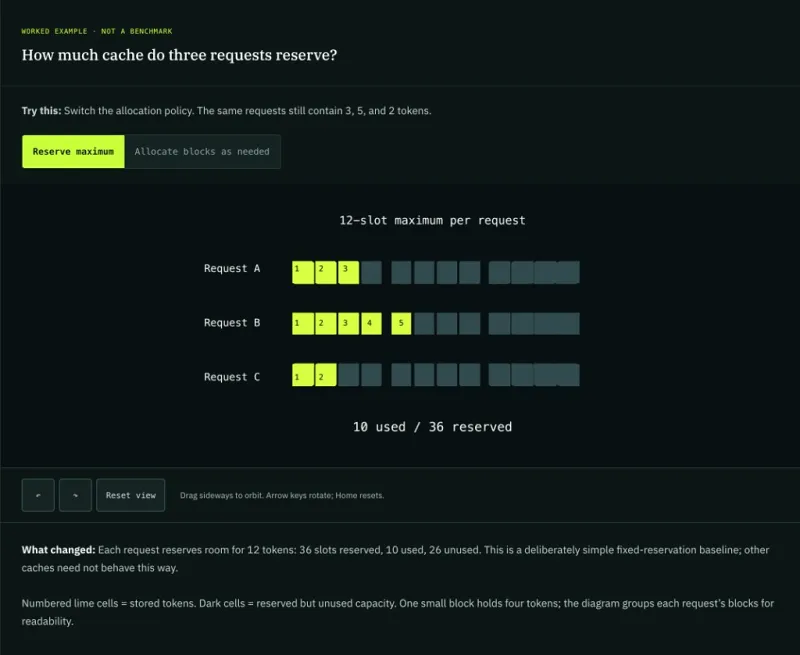
图 1:整块连续预留基线 —— 每个请求都预留 12 个 token 的空间:共预留 36 个槽位,实际使用 10 个,闲置 26 个(72% 的显存被浪费)。
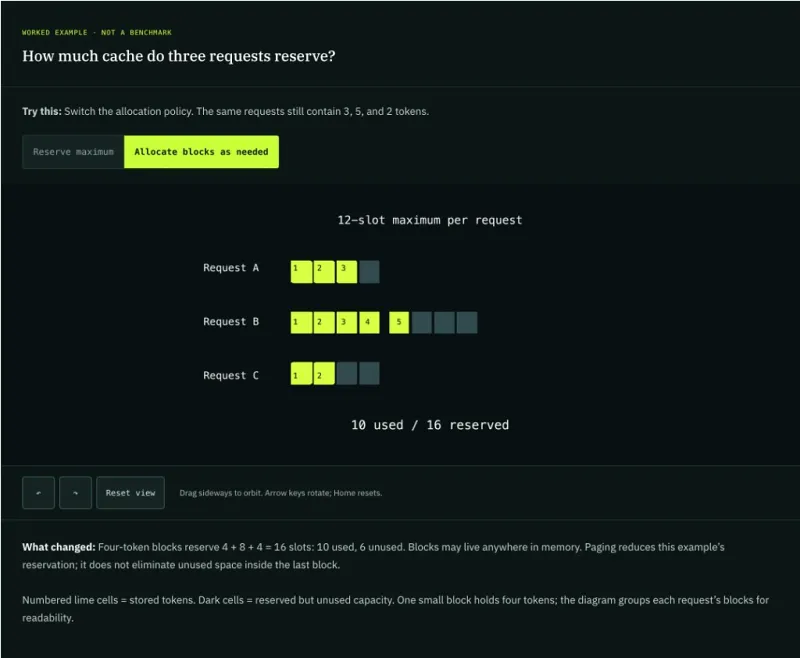
图 2:PagedAttention 按需分块分配 —— 以 4 token 为一块,共预留 4 + 8 + 4 = 16 个槽位:使用 10 个,仅闲置 6 个。物理块可以散布在显存的任意位置,为其他用户请求腾出 20 个槽位。
一个集中管理的 Block Table(块表) 负责把逻辑 token 位置映射到物理块:
- 按需分配: 只在 token 真正生成时才发放物理块。一条运行中的序列,只有最后一个块可能留有未用满的槽位。
- 把显存浪费压到 4% 以下: 内部碎片几乎消失。由于不必再为最坏情况的 prompt 囤积空显存缓冲区,同一块 GPU 可以轻轻松松承载 2 到 4 倍的并发用户流。
- 写时复制(Copy-on-Write,CoW)分支: 这对强化学习(RL)和并行树搜索堪称杀手锏。在 GRPO 这类算法中,模型会从同一个 prompt 出发生成 8 或 16 条候选 rollout。有了 PagedAttention,这 16 条候选 rollout 在物理层面共享 prompt 的 KV 显存页,只有当各候选补全彼此分叉时才会真正克隆物理内存。
3. Continuous Batching:终结最慢 token 的“暴政”
想象一辆公交车:除非车上每一位乘客都到达各自的目的地,否则拒绝让任何新乘客上车——哪怕有 3 个人在第一站就下了车,只剩 1 个人要一路坐到机场。
传统 static batching(静态批处理) 正是这样运作的。假如把分别生成 50、120、240 和 1,024 个 token 的四个请求打包成一批,那么在数百次迭代中,四个槽位里有三个的 GPU 计算核心完全空转,只为等那个 1,024 token 的“掉队者”最终吐出 <eos> token。这些被浪费的计算周期被称为 GPU 气泡(GPU bubbles)。
vLLM 实现了 continuous iteration-level batching(迭代级连续批处理)(该架构由 Orca 开创):
调度器在每一次前向传播*的边界上做决策,而不是在整个请求的边界上。
* 某个序列刚一吐出结束符 token,它的物理内存块立刻被释放回池子。
* 队列中的等待请求在下一轮 token 迭代就补进空出的槽位。GPU 核心持续保持饱和,吞吐量大幅跃升。
4. 榨干硬件:CUDA Graphs、Chunked Prefill 与 FP8
PagedAttention 解决的是显存占用问题,但想从 NVIDIA 新一代 Hopper 芯片(H100/H200)上榨出实打实的吞吐量,还得解决 kernel 调度开销:
“Python 税”与 CUDA Graphs(`enforce_eager: false`):* 在标准 PyTorch eager 模式下,每生成一个 token,运行时都要在 60 多个 transformer 层(RMSNorm、QKV projection、RoPE、attention、SwiGLU、down-projection)上接连快速启动数十个独立的 GPU kernel。在 Hopper 上,单 token 的 GEMV kernel 只需 3 到 8 微秒就能算完!但 CPU 经驱动调用去分发这个 kernel 反而要花 10 到 15 微秒。结果就是,GPU 花在等 Python 派活上的时间比真正做计算的时间还多。CUDA Graphs 的解法是在预热阶段把整段操作序列录制成一张静态执行图,此后 GPU 只需一次分发就能重放整条流水线。
Chunked Prefill:* 在活跃生成期间突然进来一个 8,000 token 的超长 prompt,过去会让所有其他请求的延迟瞬间飙升。Chunked prefill 把长 prompt 切成可控的小份(例如 512 个 token),与解码 token 平滑交错执行,让 token 间延迟保持平稳。
FP8 Tensor Core GEMM:* 用 8 位浮点运行权重和激活值,等效显存带宽直接翻倍,还能解锁 Hopper 上专用的 Cutlass FP8 矩阵核心。
LoRA 适配器热插拔:* 在多任务推理服务或 RL 训练中,你总不想每次权重一更新就重启推理引擎吧。vLLM 支持通过 NCCL 在毫秒级把 LoRA 适配器权重直接同步进正在运行的 worker 进程。
5. 实验室踩坑实录:来自 gft-studio 的真实基准测试
Twitter 上的合成基准测试截图太容易造假了。我们想知道的是:把真实的工程负载压到这套技术栈上,到底会发生什么。以下是我们在自己的研究平台(gft-studio)上收集的实测遥测数据——Qwen3.6-27B,跑在专用的 NVIDIA H100 和 H200 SXM 集群上。
基准测试 A:H100 上 Hugging Face 对比 vLLM(单卡 H100 受控冒烟测试)
在组相对策略优化(GRPO)中,模型需要针对外部环境生成一组组 rollout。为了干净地隔离推理引擎这一个变量,我们在同一块 NVIDIA H100 80GB SXM GPU 上跑了一个受控的 3 步测试,提示词、基础权重、随机种子和 SQL 任务全部严格保持一致:
- Hugging Face 基线(1x H100 80GB):完成 3 / 3(成功),平均每步生成耗时 283.7 s,平均每步总耗时 338.9 s,实测加速比 1.00x(基线)
- vLLM + CUDA Graphs(1x H100 80GB):完成 3 / 3(成功),平均每步生成耗时 78.9 s,平均每步总耗时 143.5 s,实测生成提速 3.59x(整步提速 2.36x)
在完全相同的芯片上,vLLM 把每步生成的实际耗时从 283.7 秒压到了 78.9 秒——纯生成速度提升 3.59 倍,单步总耗时也拿到了 2.36 倍的改善。
注意: 这只是一次 3 步执行的冒烟测试。它虽然能在相同硬件上干净地隔离引擎机制这一变量,但并没有评估 500 步尺度下的长期策略收敛表现。
基准测试 B:CUDA Graphs 在 H200 上到底有多大作用?
为了实测主机端 Python 调度开销的影响,我们在 NVIDIA H200 硬件上测试了 Qwen3.6-27B,对比 eager 执行(enforce_eager: true)与已捕获的 CUDA Graphs(enforce_eager: false):
- L0 Latent Think(确定性),PyTorch Eager 模式,
enforce_eager: true:5 / 5(成功),平均每步生成 437.9 s,实测比值 1.00x(基线) - L0 Latent Think(确定性),CUDA Graphs 回放,
enforce_eager: false:5 / 5(成功),平均每步生成 101.3 s,实测提速 4.32x - L2b Latent GRPO(策略梯度),PyTorch Eager 模式,
enforce_eager: true:5 / 5(成功),平均每步生成 391.8 s,实测比值 1.00x(基线) - L2b Latent GRPO(策略梯度),CUDA Graphs 回放,
enforce_eager: false:50 / 50(成功),平均每步生成 132.7 s,实测提速 2.95x
数字说明了一切:在单 token 解码迭代中,回放预先录制好的 CUDA Graphs,仅仅靠消除主机端的驱动停顿,就把生成时间压缩了 2.95 到 4.32 倍。
补充遥测数据:留档的训练记录
历史多跳路由(multi-hop routing)训练运行记录(Qwen3.6-27B,vLLM 生成):
- 运行 ID
1788615027:L0(仅答案目标),强制 eager,5 步,每步生成 437.9 s,每步总计 582.7 s - 运行 ID
1788616147:L0(仅答案目标),未强制 eager,5 步,每步生成 101.3 s,每步总计 247.9 s - 运行 ID
1788626786:L2b(采样隐变量目标),强制 eager,5 步,每步生成 391.8 s,每步总计 567.9 s - 运行 ID
1788656686:L2b(采样隐变量目标),未强制 eager,50 步,每步生成 132.7 s,每步总计 291.6 s
基准测试 C:生产级服务与互联瓶颈
在一次推理服务试点中,我们使用标准 AIPerf 负载(564 输入 token,128 输出 token),在并发不断加大的压力下测试 Qwen3.8-27B:
- 1x H100 BF16,客户端并发 1:TTFT(p50 / p99)100.7 ms / 106.8 ms,输出吞吐 48.4 tok/s,扩展倍数 1.0x
- 1x H100 BF16,客户端并发 4:TTFT(p50 / p99)222.2 ms / 263.5 ms,输出吞吐 179.5 tok/s,扩展倍数 3.71x
- 1x H100 BF16,客户端并发 8:TTFT(p50 / p99)406.7 ms / 487.1 ms,输出吞吐 307.4 tok/s,扩展倍数 6.35x
- 2x H100 FP8(Cutlass DP2),客户端并发 8:TTFT(p50 / p99)172.9 ms / 274.5 ms,输出吞吐 483.2 tok/s,扩展倍数 9.98x
- 2x H100 FP8(Together TP2),客户端并发 8:TTFT(p50 / p99)263.2 ms / 387.4 ms,输出吞吐 982.6 tok/s,扩展倍数 20.30x
一段工程实战血泪史: 注意张量并行(TP2)下 982.6 tok/s 的峰值——这个速度是在通过超高速 NVLink 互联的单节点上跑出来的。而在测试早期,我们曾尝试通过标准 VPC 网络互联,搭一套自定义的跨节点 TP2 方案。结果呢?吞吐量直接崩到了 75.8 tok/s!除非你的 GPU 之间共享高带宽 NVLink,否则不要跨物理机跑张量并行——网络延迟会把你的吞吐量打得惨不忍睹。这种场景请改用数据并行(独立 worker)。
6. 生产环境检查清单:让 vLLM 稳定运行,告别凌晨三点的告警
如果你正在企业级基础设施中部署 vLLM,下面是我们实际依赖的架构模式:
- 双层入口架构(Two-Tier Ingress):在前端放置一个具备容错能力的弹性网关(如 LiteLLM),负责处理认证、团队配额和审计日志;再通过主动探测队列深度的健康检查,把流量分发到后端各个 vLLM worker 上。
- 不可变本地存储(Immutable Local Storage):千万不要让 worker 在启动时从公共对象存储拉取 50 GB 的权重文件。把模型 checkpoint 预先挂载到本地 NVMe 或高速只读 PVC 上,Pod 就能在几秒内完成启动。
- 盯紧共置场景下的显存预算(Colocated Memory Budget):如果你在跑 RL 后训练,trainer 和 vLLM 推理 worker 共用同一块 GPU,请设置
gpu_memory_fraction: 0.35。这样能为 vLLM 预留约 28 GB 显存,同时给 PyTorch 的梯度、激活值和优化器状态留下约 50 GB。一旦忽视这个平衡,训练在长轨迹上跑起来的那一刻,CUDA OOM 崩溃立刻就会发生。
结语
vLLM 并不会让模型奇迹般地变聪明,但它能把 LLM 推理服务从一段脆弱、显存吃紧的脚本,变成一套可预测、坚如磐石的工程系统。你尊重硬件,硬件自然会给你回报。
原文:https://dev.to/g_factor/high-throughput-llm-inference-training-a-deep-dive-into-vllm-5818(作者 @gfactor)