原文:https://dev.to/kanunilabs/how-to-build-a-sales-dashboard-on-a-million-real-rows-in-react-datagrid-4io8(作者 @kanunilabs)
我做过的大多数销售数据仪表盘,都是把每一个问题都丢给服务器:改一个筛选条件,前端就发出一个请求,后端跑一条 SQL 查询,再返回一页数据行。当数据非常庞大或者涉及隐私时,这是正确的设计。但对于“11 月哪个国家买得最多?”这类问题,如果整个数据集本来就能塞进一个浏览器标签页,这套机制就实在是大材小用了。
于是我们反其道而行之:拿了一份刚过一百万行的真实销售数据集,一次性送进浏览器,之后的一切都在浏览器端完成——排序、搜索、分组、透视、绘图。本文会结合 React 代码逐一拆解每个环节,并顺带指出哪些地方会变慢。
数据集
我们使用的是 UCI 机器学习仓库中的 Online Retail II 数据集。它是一家英国在线零售商(主营礼品和家居用品)从 2009 年 12 月到 2011 年 12 月共两年的交易记录:1,067,371 行,每行对应一条发票明细。每行字段包括发票号(invoice number)、商品编码(stock code)、商品描述、数量、英镑单价、时间戳、客户 ID 和国家。数据以 CC BY 4.0 协议发布,你也可以基于它构建自己的项目。
既然是真实数据,就免不了销售数据惯有的那种脏乱:作废发票的发票号以"C"开头,数量为负数;还有一些明细压根不是商品,比如"Manual"(人工调整)、"AMAZON FEE"(亚马逊费用)、"Adjust bad debt"(坏账调整)。这些行我们全部保留。
成品页面已经上线:/demos/online-retail。页面分为两部分——一个展示全部交易的表格,和一个带图表的透视表,下文就按这个顺序来搭建。
把一百万行数据装进浏览器
这个数据集的 CSV 版本有 91 MB,gzip 压缩后也有 14.8 MB。指望访客下载这么大的文件并不现实,但其中大部分其实是重复信息:八列中有五列的取值都来自一个很小的集合——43 个国家、约 5,300 种商品、约 53,600 张发票。我们把这五列各自存成一个字典,每行只保留一个整数索引,下载体积就降到了 5.8 MB(gzip 后)。
把它们解码回普通的行对象,一个循环就够:
const res = await fetch('/demos/online-retail/retail.v1.json.gz');
const text = await new Response(
  res.body!.pipeThrough(new DecompressionStream('gzip')),
).text();
const { dicts, cols, rows: n } = JSON.parse(text);

const rows = new Array(n);
for (let i = 0; i < n; i++) {
  const quantity = cols.quantity[i];
  const price = cols.price[i];
  rows[i] = {
    id: i + 1,
    invoice: dicts.invoice[cols.invoice[i]],
    description: dicts.description[cols.description[i]],
    country: dicts.country[cols.country[i]],
    quantity,
    price,
    revenue: quantity * price,
  };
}
页面上实际使用的版本会按每 50,000 行一批分片解码,并在每批之间把控制权交还给浏览器,这样在构建上百万个对象的过程中,进度条也能一直动下去。
表格
表格直接接收这些原始数据行:
import { DataGrid } from '@kanunilabs/datagrid-react';

const gbp = new Intl.NumberFormat('en-GB', { style: 'currency', currency: 'GBP' });

const columns = [
  { field: 'invoice', headerName: 'Invoice' },
  { field: 'description', headerName: 'Product', width: 300 },
  { field: 'quantity', headerName: 'Qty', dataType: 'number' },
  { field: 'revenue', headerName: 'Revenue', dataType: 'number',
    valueFormatter: (v) => gbp.format(v) },
  { field: 'country', headerName: 'Country' },
];

<DataGrid
  dataSource={rows}
  rowKey="id"
  columns={columns}
  toolbar
  statusBar
  groupPanel
  summaries={[
    { columnId: 'quantity', type: 'sum' },
    { columnId: 'revenue', type: 'sum' },
  ]}
/>
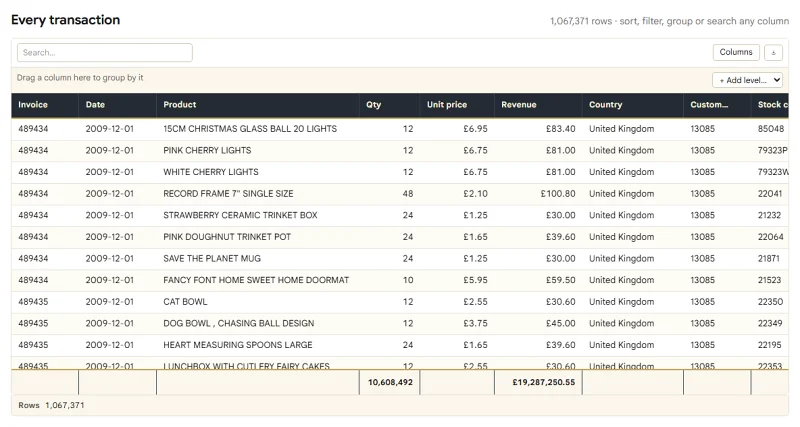
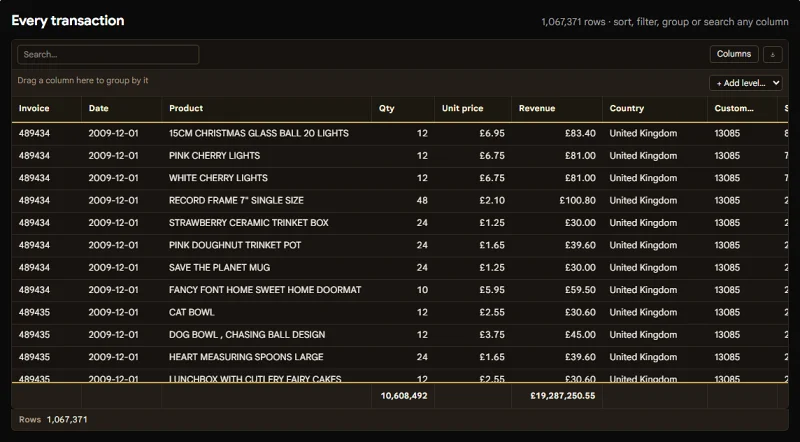
DOM 中只存在屏幕上可见的那些行,因此在一百万行里滚动到底部和滚动到顶部的开销完全相同。页脚显示的是整个结果集的合计:两年共计 10,608,492 件商品,收入 £19,287,250.55。
按收入排序
点击 Revenue 列头即可排序。排序操作在 Web Worker 中执行,因此在重排一百万行数据的同时,页面依然保持响应。我们的基准测试页面列出了在 100 万行生成数据上的实测耗时,还附带一个脚本,你可以自己跑一遍。
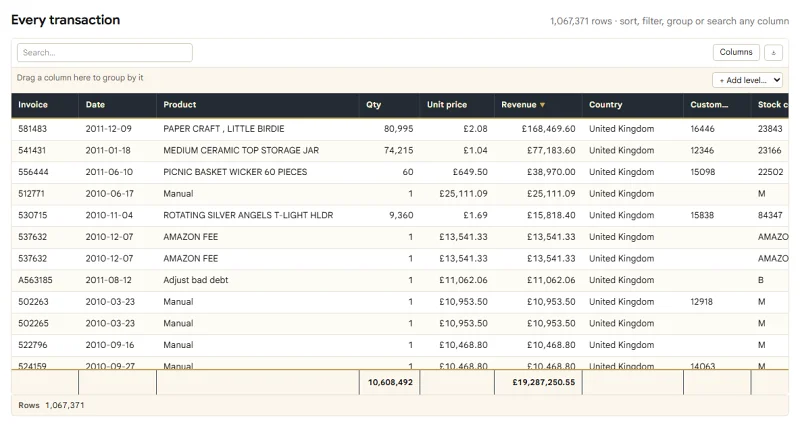
排第一的是一笔 80,995 只纸艺小鸟的订单,单价 £2.08,单行金额合计 £168,469.60。反向排序后,第一行又是同一笔订单——发票 C581484 当天作废,金额为 −£168,469.60。金额第二大的明细(74,215 只陶瓷储物罐)同样有一笔对应的作废记录。没有谁会围绕这种场景去规划仪表盘,但在真实数据上,排序后最先跳出来的就是它。
搜索
在搜索框中输入内容,表格会同时对所有列进行过滤并高亮匹配项。"WHITE HANGING HEART" 命中了 1,067,371 行中的 5,918 行,底部汇总栏也随之更新为该结果:93,050 件、£257,533.90 销售额。
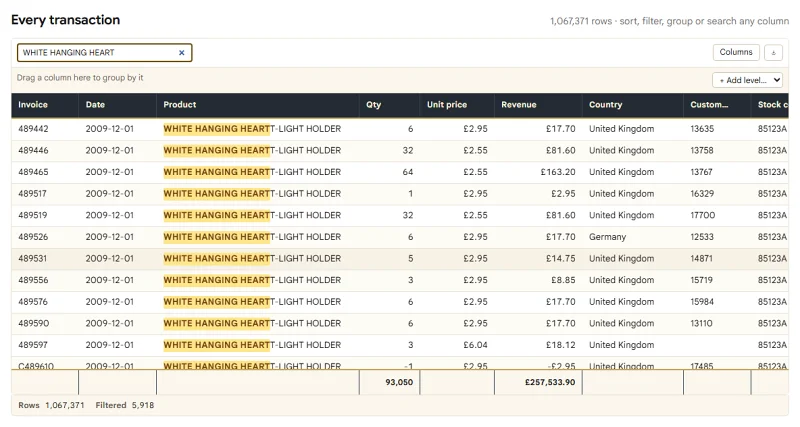
搜索匹配的是你看到的显示文本,所以搜 "£2.95" 和搜 "2.95" 效果相同。这意味着第一次搜索时,表格要对每个格式化列的每一行都做一次格式化——我们自己代码里的一行,就是在这里吃掉了一分钟。
我们最初把格式化函数写成 v.toLocaleString('en-GB', { style: 'currency', currency: 'GBP' })。带选项调用时,toLocaleString 每次都会新建一个 Intl.NumberFormat 实例,因此在开发构建下,第一次搜索卡在 "Preparing data" 上超过了一分钟。换成上面代码里那种共享的格式化实例后,同一台笔记本上只需约六秒。如果你要在大型表格中格式化数字,务必只构建一次格式化器。
按国家分组
把 Country 列头拖进表格上方的分组栏,数据行就会按国家折叠成组,每组自带行数和汇总值。
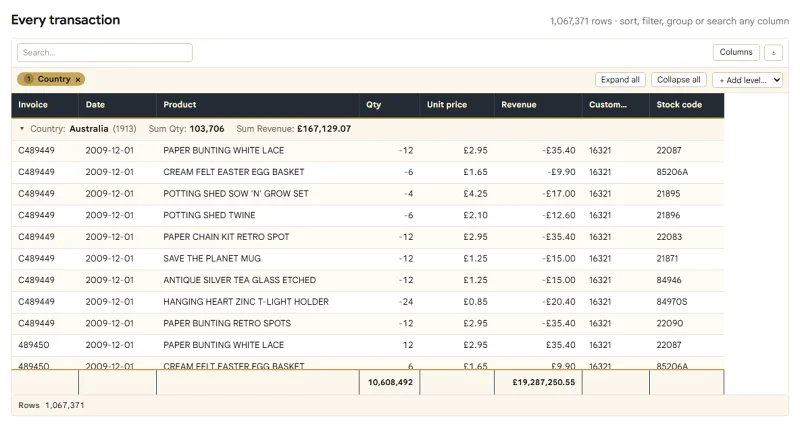
分组功能、分组栏和底部汇总额都包含在免费的 Community 包里。本文截图中的分组汇总值属于付费的 EnterpriseDataGrid,本页面用的正是它。
按国家和年份做透视
透视表可以回答下一个问题——每个市场在各年份表现如何——而且不用写一行查询语句。用三个字段就能描述:
import { BasePivotGrid as PivotGrid } from '@kanunilabs/pivotgrid-react';

const fields = [
  { id: 'country', dataField: 'country', caption: 'Country',
    dataType: 'string', area: 'row', areaIndex: 0 },
  { id: 'year', dataField: 'year', caption: 'Year',
    dataType: 'string', area: 'column', areaIndex: 0 },
  { id: 'revenue', dataField: 'revenue', caption: 'Revenue',
    dataType: 'number', area: 'data', areaIndex: 0, summaryType: 'sum' },
];

<div style={{ position: 'relative', height: 520 }}>
  <PivotGrid data={rows} initialFields={fields} />
</div>
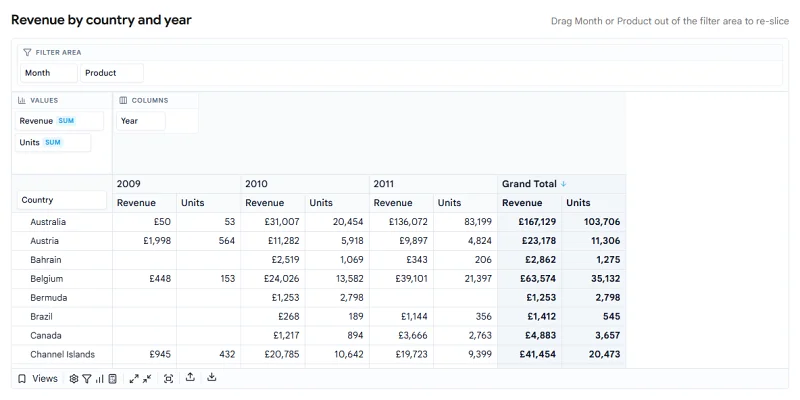
注意外层容器。透视表会基于最近的定位祖先元素进行布局,所以要给它一个有高度且 position: relative 的容器。在我们的页面上,缺了这个容器,透视表直接叠画在了上方的表格上。
透视表中的每个字段都可以在行、列、值和筛选区域之间自由拖动,每次放下都会对百万行数据重新聚合。
按月的销售额
把布局换成行放月份、销售额作为唯一度量,图表就变得可读了。行放国家时则不然:英国占了绝大部分销售额,其他国家的柱子都细成一条缝。
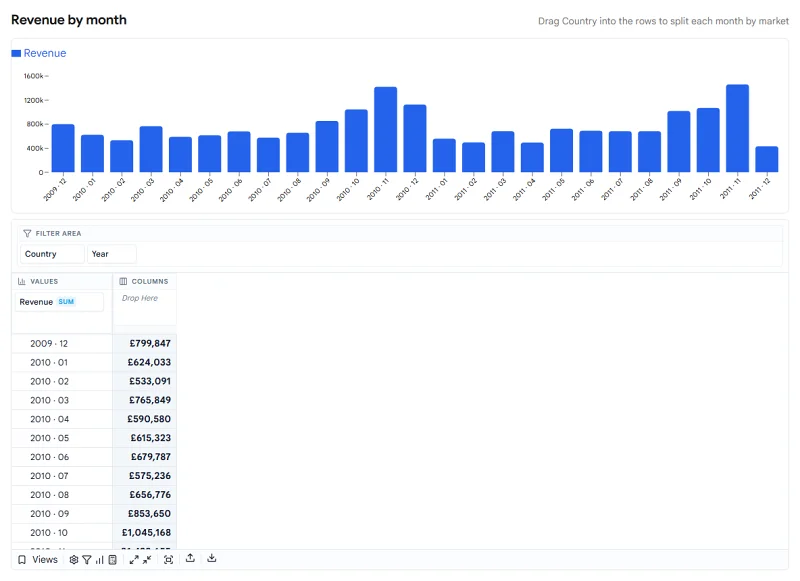
两年都是 11 月达峰:2010 年为 £1,422,655,2011 年为 £1,461,756。2011 年 12 月的 £433,686 看起来像暴跌,但那只是因为数据集截止到 12 月 9 日。在有人基于它做预测之前,这一点值得先核实。
图表跟随透视表联动,所以把透视表筛选到某个国家时,图表会只针对该国家重绘。图表功能属于付费的 PivotGrid Enterprise 包。
深色主题
表格自带六套主题。这里用的是 theme="kanuni-midnight":
这种方案的代价
把整个数据集发给浏览器是一种权衡,并非对所有仪表盘都合适。
- 下载体积。 5.8 MB,每次访问都要下载一次。对内部工具没问题,对弱网环境下的手机就偏重了。
- 内存。 只要标签页开着,一百万个行对象就一直驻留在其中。本文没有专门测量内存占用。
- 首次开销。 第一次搜索要为格式化后的文本建索引,第一次透视布局要完成全量聚合。两者之后都会被缓存,但第一次是秒级而非毫秒级。
- 数据都在同一个标签页里。 如果数据涉及隐私、每秒都在变化,或者体量再大十倍,那它还是应该放在服务器端。
亲手试试
仪表盘地址:/demos/online-retail。还有几个链接可以直接打开特定状态:按销售额排序、按国家分组、带月度图表 和 深色主题。DataGrid 文档和 PivotGrid 文档覆盖了本文用到的所有 props。
数据来源:Online Retail II,UCI 机器学习仓库(Chen, 2019),CC BY 4.0 协议。
原文:https://dev.to/kanunilabs/how-to-build-a-sales-dashboard-on-a-million-real-rows-in-react-datagrid-4io8(作者 @kanunilabs)