我前面已经很多期讲过了人工智能对人类理解造成的危害了
接下来我们将搞清楚一个问题:人工智能到底是用什么方式学习资源的
就目前情况而言,搜索引擎是不得不品的一环
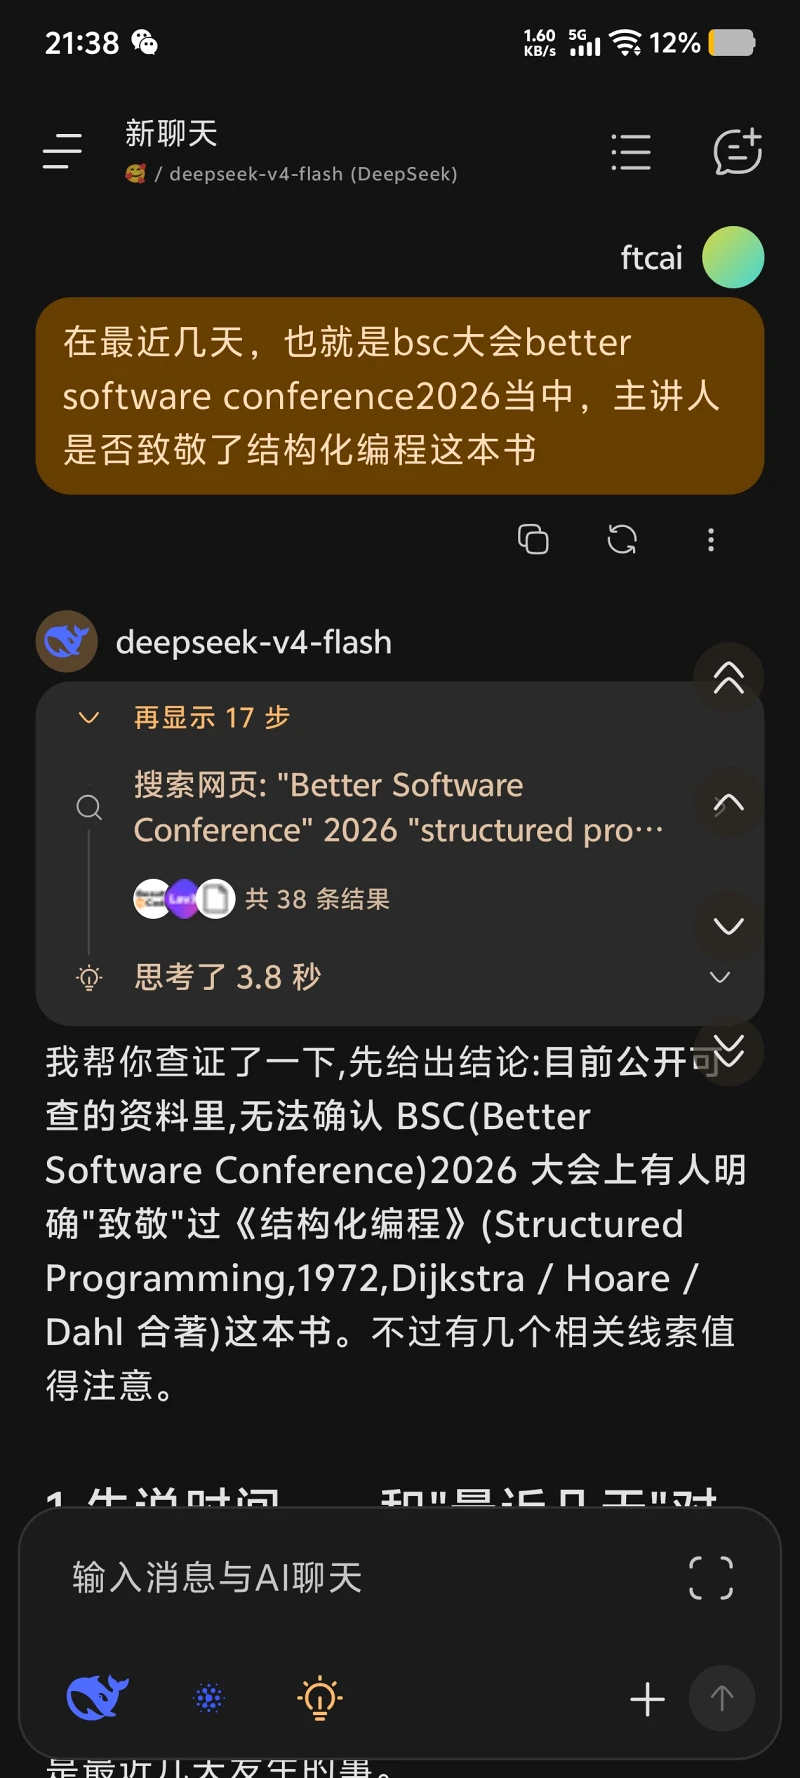
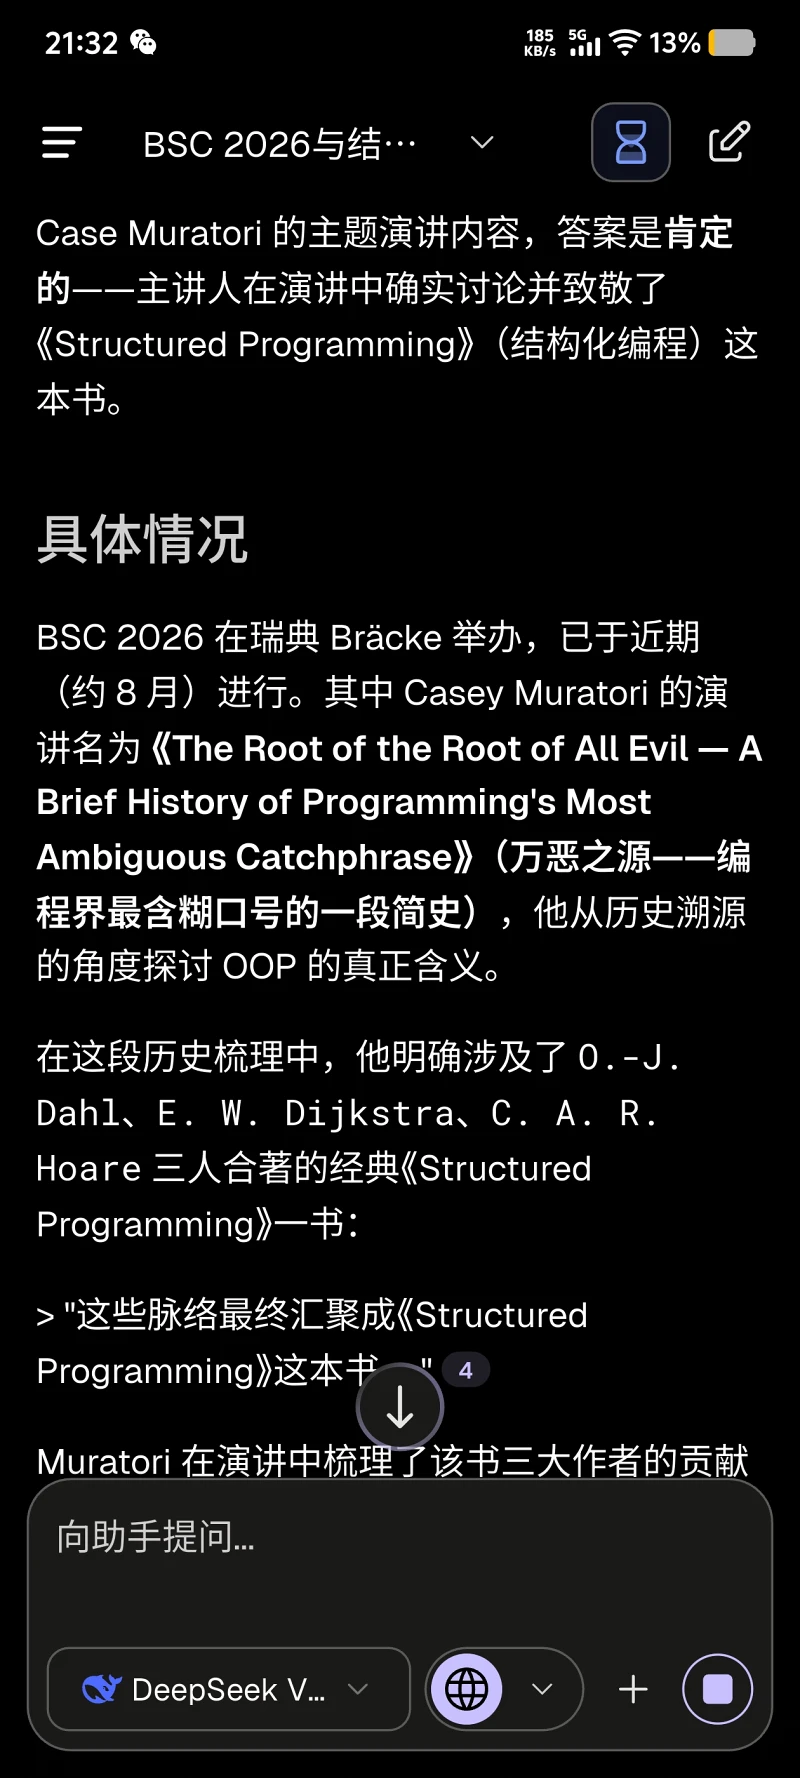
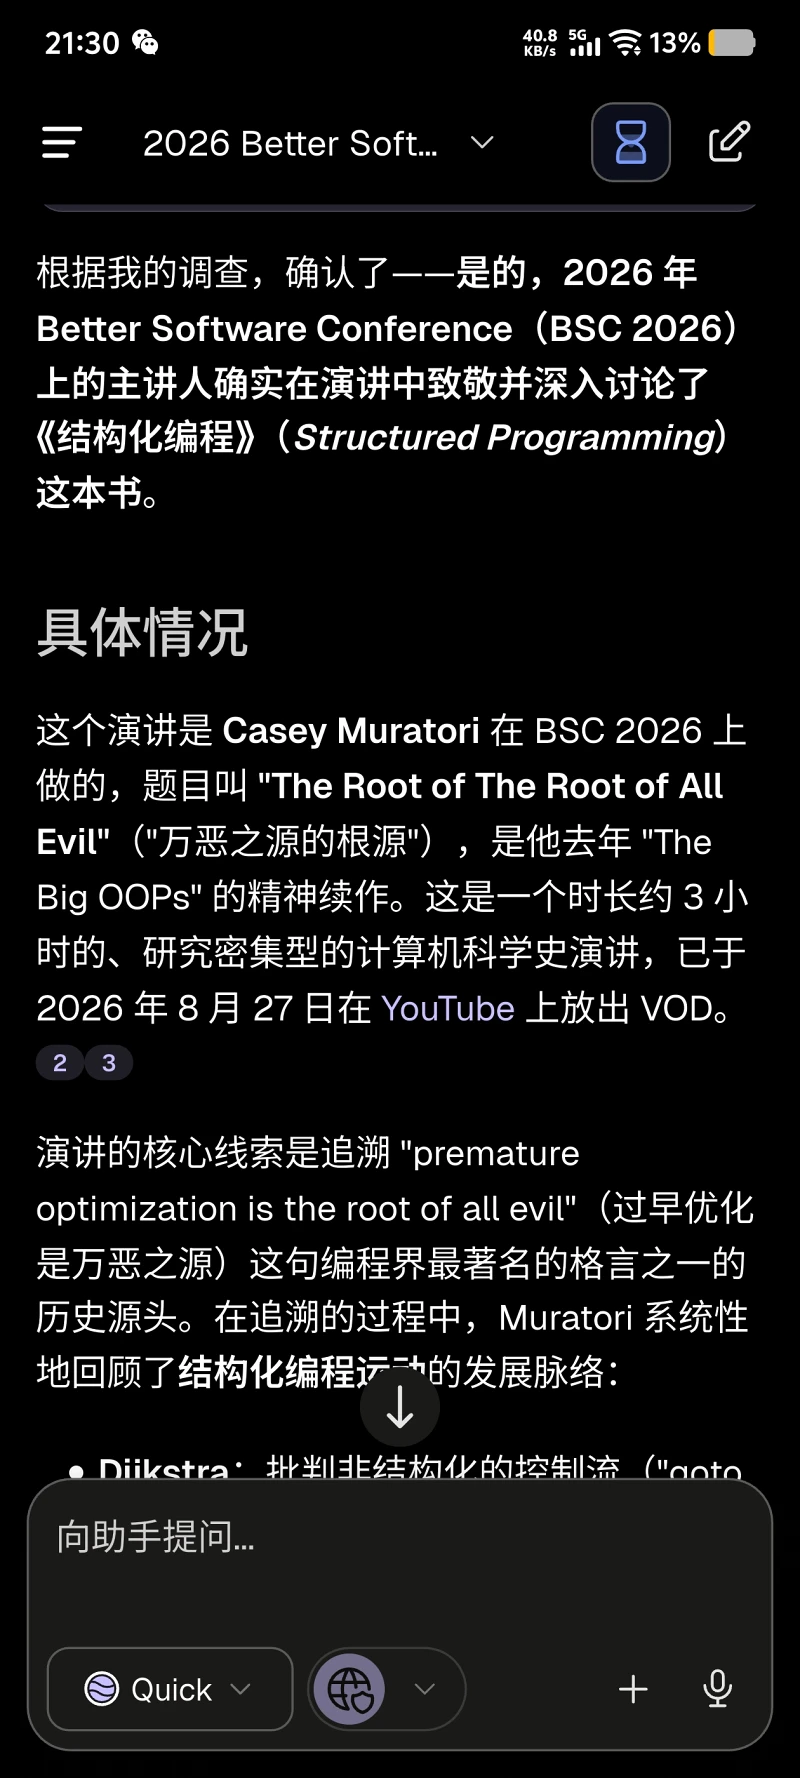
废话不多说我们先看我测试的截图
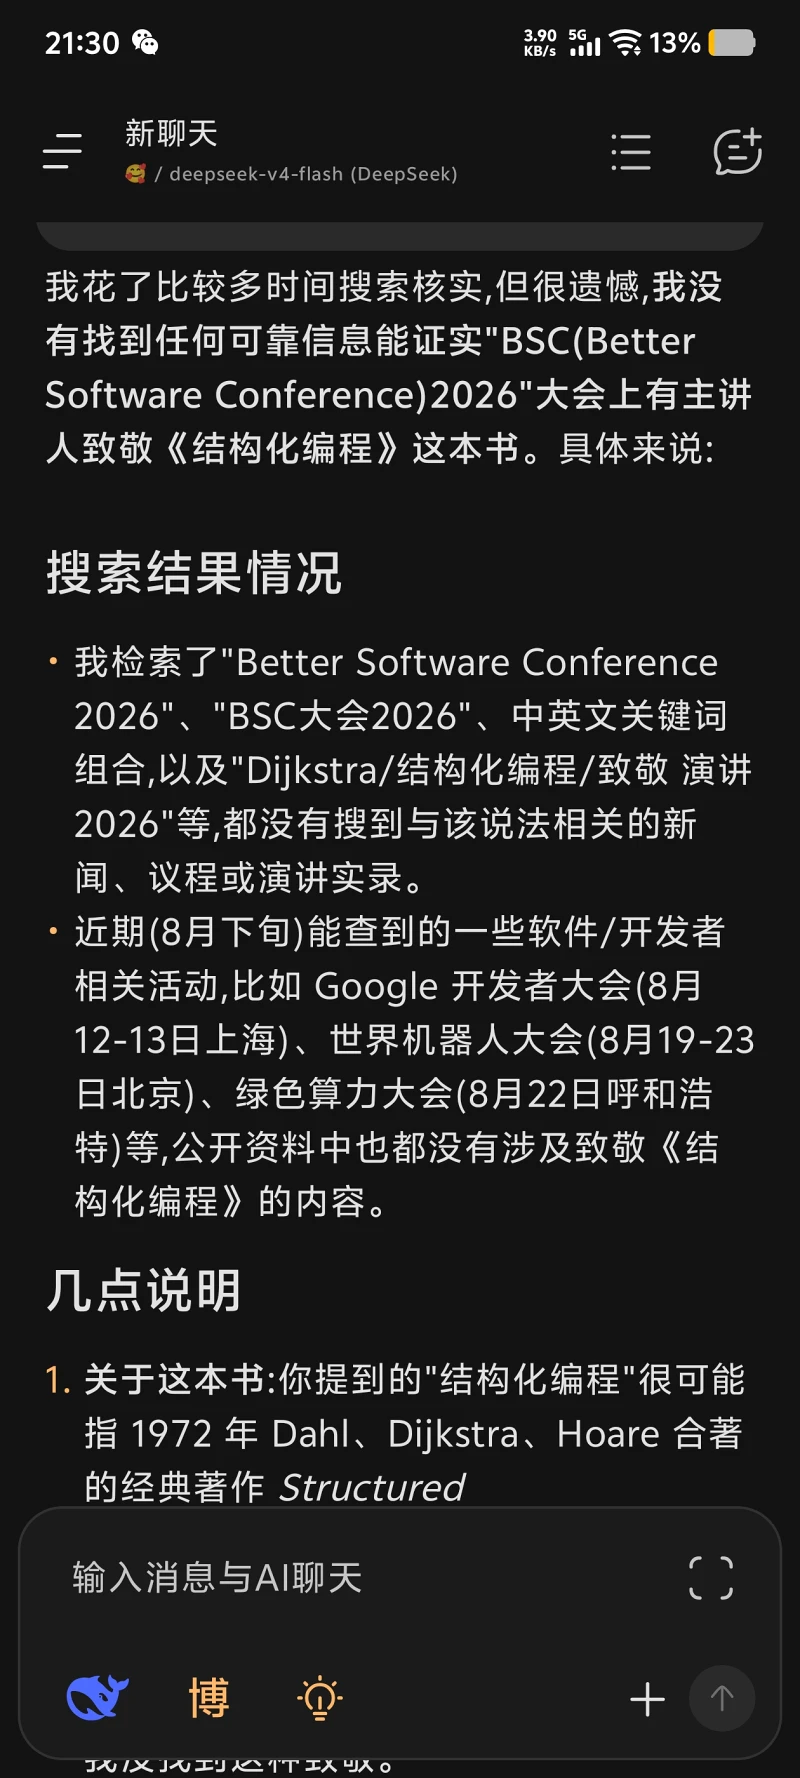
第一张照片是使用某杭州人工智能搜索引擎+dsflash
第二张照片是某北京人工智能搜索引擎再加上dsflash
第三张照片是 kagi搜索引擎+dsflash
第四张照片是 kagi搜索引擎+kagi小模型
我只能从吐字speed的角度来看 这个小模型甚至是小到不可想象
通过这样的测试我们能得出个结论 如果是基于消息/还没有来得及进数据库的知识
基本上国内互联网已经搜不出来有价值的信息
甚至包括早期的一些经典杂志也不一定能搜得到
当然我不是说 kagi 在家立马就能用了他一个月月租5美元不算很便宜
而且他对某些已经进入历史仓库的老网站搜索的也不是很准确(相机评测网站dpreview 很老的能看到极限暗光的评测他就没有给我找到)
讲白了这就是
人还是需要用自己的知识武装自己的大脑
通过基本的理论分析破除历史周期律看到不会更改或者说至少在我们死亡之前不会更改的东西
抓住这个东西然后做推理才是能够被防止人工智能取代的唯一方式
很可惜的是在我了解的人当中
现代汉语都不会说了
必须要把文字打给人工智能才会说话。